结论:别花钱买API了,先把你手里的免费额度用干净
很多人觉得AI API贵,GPT-4o调用一次几毛钱,DeepSeek虽然便宜但架不住量大。但真相是——几乎每家AI平台都有免费额度,只是没人愿意一个一个去注册、管理、对接。
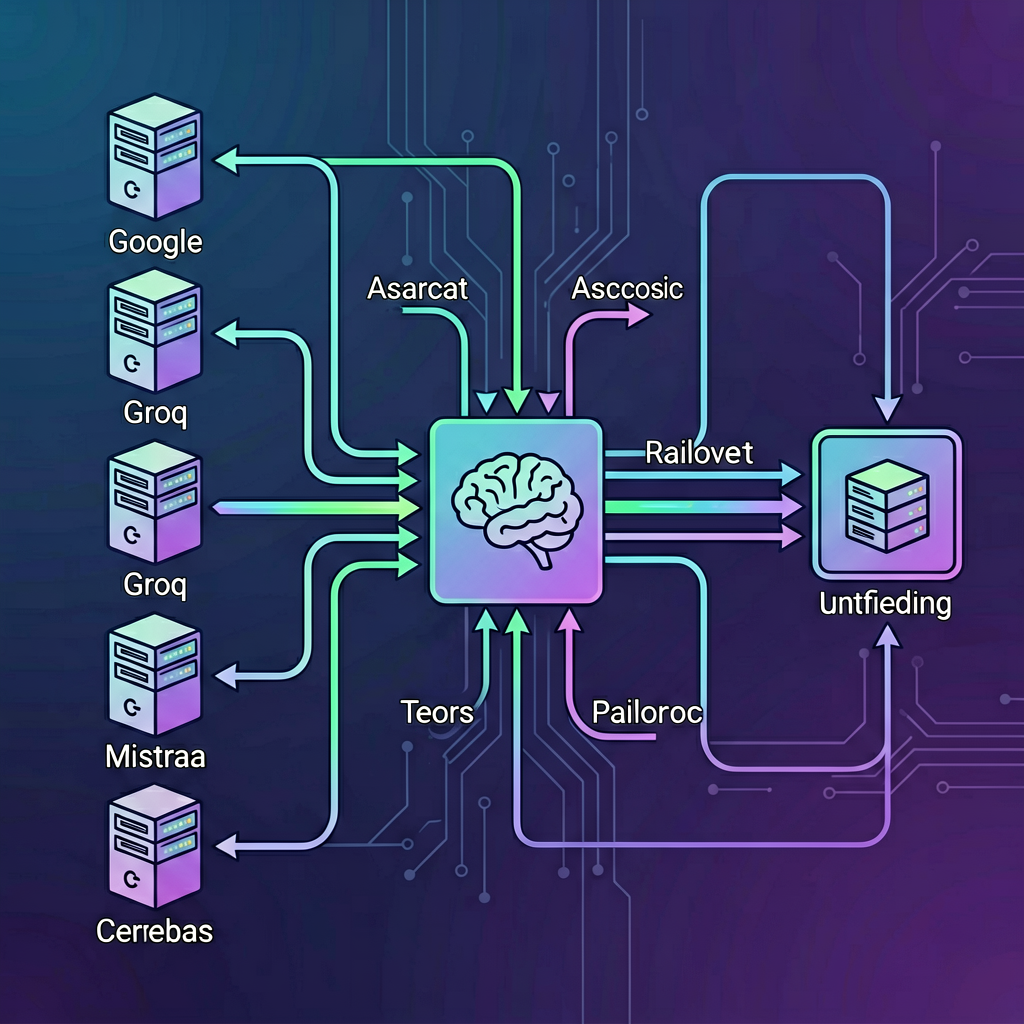
GitHub上有个叫 FreeLLMAPI 的开源项目(15.2k star),直接把这个问题解决了:把18家AI平台的免费额度聚合成一个统一的OpenAI兼容接口。你只需要部署一次,所有应用都指向这一个地址,后台自动在各个免费额度的池子里调度。
核心数据:月均1.7B Token、161个免费模型、18家提供商。 对于个人开发者、Side Project、原型验证来说,这个量级完全够用。
而且这个项目不只是简单聚合——它有智能路由、自动故障转移、每Key用量追踪、加密存储,甚至支持Anthropic格式(Claude Code也能用)。TypeScript编写,Docker一键部署,40MB内存占用。
一、三大核心组件
FreeLLMAPI的架构可以拆成三个部分:
1. 智能路由器(Router)
核心是 /v1/chat/completions 的请求分发。当你发一个请求过来,路由器会:
- 根据你配置的**Fallback Chain(回退链)**选择最优提供商
- 检查该提供商的RPM/RPD/TPM/TPD配额是否还有余量
- 如果被限流(429)或超时,自动跳到下一个提供商
- 最多尝试20次回退
还支持Sticky Session:多轮对话30分钟内保持同一模型,避免中途切换模型导致的幻觉飙升。
2. 密钥管理器(Key Manager)
API密钥用 AES-256-GCM 加密后存入SQLite,只在请求发出前在内存中解密。你只需要在Dashboard上添加一次密钥,应用端用统一的 freellmapi-xxx Token 认证,永远不会暴露上游密钥。
3. 管理面板(Dashboard)
React + Vite 构建的Web UI,支持:
- 密钥管理(添加/删除/查看健康状态)
- Fallback Chain拖拽排序
- 实时分析(延迟、Token用量、成功率、按提供商拆分)
- Playground在线测试
- 健康检查(自动标记密钥为 healthy/rate_limited/invalid/error)
二、支持的提供商阵容
| 提供商 | 代表模型 | 特点 |
|---|---|---|
| Gemini 2.5 Flash | 免费额度大,速度快 | |
| Groq | Llama 3.3/4, Qwen3 | 推理速度极快 |
| Cerebras | Qwen3 235B | 超大模型免费 |
| Mistral | Large 3, Codestral | 代码能力强 |
| OpenRouter | 21个免费模型 | 聚合中的聚合 |
| GitHub Models | GPT-4.1, GPT-4o | 微软背书 |
| Cloudflare | Kimi K2, GLM-4.7 | 边缘计算 |
| NVIDIA NIM | 40 RPM免费 | 评估用途 |
| HuggingFace | DeepSeek V4, Kimi K2.6 | 开源模型集散地 |
| Z.ai (智谱) | GLM-4.5/4.7 Flash | 国产模型 |
| Ollama Cloud | GLM-4.7, Kimi K2 | 云上Ollama |
| Cohere | Command R+ | 企业级RAG |
| 还有Kilo、Pollinations、LLM7、OVH、AI Horde等 | 匿名可用 |
另外还支持自定义提供商——你可以把本地llama.cpp、LM Studio、vLLM或任何OpenAI兼容端点加进去。
三、搭建步骤(Docker版,3分钟搞定)
前提条件
- Docker + Docker Compose
- OpenSSL(生成加密密钥)
步骤1:一键安装
curl -fsSL https://freellmapi.co/install.sh | bash
这行命令会:创建 ~/freellmapi 目录、生成加密密钥、拉取镜像、启动容器。重复运行安全,.env 会被保留。
步骤2:手动安装(更可控)
git clone https://github.com/tashfeenahmed/freellmapi.git
cd freellmapi
ENCRYPTION_KEY="$(openssl rand -hex 32)"
printf "ENCRYPTION_KEY=%s\nPORT=3001\n" "$ENCRYPTION_KEY" > .env
docker compose up -d
步骤3:配置
打开 http://localhost:3001:
- 注册管理员账号(首次运行设置)
- 进入 Keys 页面,添加各平台的API Key
- 在 Fallback Chain 页面拖拽排序(哪个提供商优先用)
- 从 Keys 页面顶部复制你的统一API Key
步骤4:对接应用
以Python为例,只需要改 base_url:
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:3001/v1",
    api_key="freellmapi-你的统一Key"
)

response = client.chat.completions.create(
    model="auto",  # 让路由器自动选
    messages=[{"role": "user", "content": "你好"}]
)
Claude Code用户也能用:FreeLLMAPI实现了 /v1/messages 端点(Anthropic格式),直接指向即可。
四、实战场景
场景1:个人开发者的测试环境
我自己的用法:本地跑一个Docker容器,所有Side Project的API调用都指向它。每天写代码时调用的模型自动在Google Gemini和Groq之间切换,哪家配额多就用哪家。一个月下来API账单为0。
场景2:多模型对比评测
想对比Gemini 2.5 Flash和Mistral Large 3的效果?在Dashboard的Playground里直接选模型测试,或者在代码里指定 model="gemini-2.5-flash" 或 model="mistral-large-3"。
场景3:CI/CD中的自动化测试
在GitHub Actions里跑一个FreeLLMAPI容器,测试脚本用免费额度跑集成测试。不花钱、不泄露API Key、测试环境一致。
五、踩坑记录
| 问题 | 原因 | 解决 |
|---|---|---|
| 429 Too Many Requests | 某个提供商的免费配额用完了 | 检查Dashboard的用量分析,换Fallback Chain顺序 |
| 模型切换后回答质量下降 | Sticky Session过期(30分钟) | 长对话保持活跃,或在同一会话内连续提问 |
| Docker容器外网访问不了 | 默认绑定127.0.0.1 | 启动时加 HOST_BIND=0.0.0.0 |
| 某些模型不支持Tool Calling | 不同提供商的工具调用格式不统一 | 在Dashboard里查看模型详情,选支持Tool Calling的模型 |
| 违反ToS被封号 | 部分平台禁止代理/聚合使用 | 见下方「ToS注意事项」 |
| 加密密钥丢失 | .env 文件被删除 | 备份 ~/freellmapi/.env,密钥丢失后已存储的API Key无法解密 |
ToS注意事项
FreeLLMAPI官方做了详细的ToS审查(2026年5月更新),核心结论:
- ✅ 安全:Groq、Cerebras、Mistral、OpenRouter、Ollama Cloud、OVH、AI Horde
- ⚠️ 谨慎:Google Gemini(新条款限制商业用途)、Cloudflare(模糊)、NVIDIA(仅评估)、GitHub Models(仅实验)
- ❌ 避免:Cohere(禁止个人用途)
黄金法则:每家平台一个账号、不转售、不分享给他人、不把免费层当生产环境用。
六、总结
FreeLLMAPI解决了一个真实痛点:AI平台的免费额度不是没有,而是太分散。18家平台、161个模型、月均1.7B Token,这些数字说明免费层的总量其实相当可观。
对于个人开发者来说,与其每个月花几十到几百块买API,不如花10分钟部署一个FreeLLMAPI,把白嫖的资源用到极致。模型能力现在差距没那么大,但免费额度加起来的总调用量确实够用。
项目地址:github.com/tashfeenahmed/freellmapi
最后提醒: 这个项目是个人实验和学习用的,不是生产级方案。如果你真做出了一个要上线的产品,记得在上线前换成付费API。
中国AI全球发展位次:中美模型能力差距已缩小至2.7%(斯坦福HAI 2026),AI投资额差距23:1,但论文和专利数量均为全球第一,工业机器人装机量9倍于美国。国产模型(智谱GLM、通义千问、DeepSeek)也出现在FreeLLMAPI的提供商列表中,说明中国AI生态正在加速融入全球开源体系。