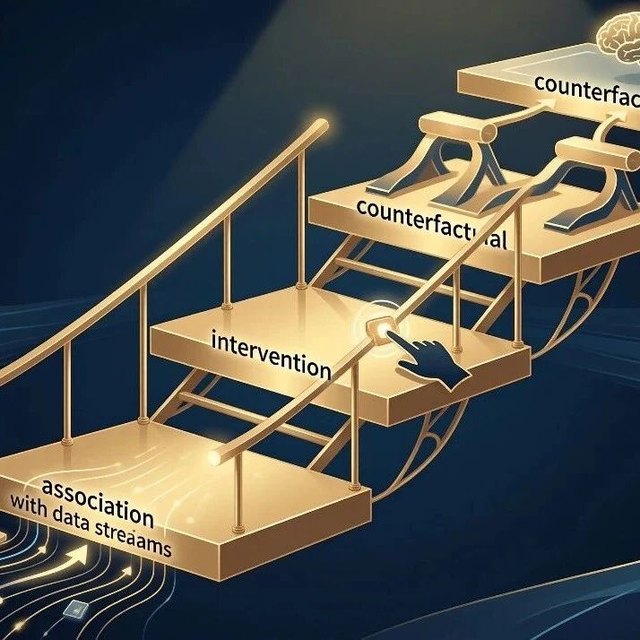
结论先行:图灵奖得主、因果推理奠基人朱迪亚·珀尔(Judea Pearl)的判断很直接:大模型"会讲因果",是因为人类早就替它解释过这个世界——它读到的是医生诊断过的病例、研究者筛选过的数据、写满结论的教材。它能流畅复述人类已有的因果解释,但还没证明自己具备独立的因果发现能力。LLM 是构建 AGI 的重要工具,但工具箱里还缺三块:干预演算、反事实推理、可操作的世界模型。
一、从"一千德南"到贝叶斯网络:一个不妥协的人
珀尔把研究性格追溯到中学时代。1948 年以色列建国前,一批遭纳粹迫害的德国学者逃到巴勒斯坦地区,没能在大学找到教职,其中一些人进了中学教书。他们不讲死记硬背的解题步骤,而是沿着科学发现实际发生的顺序讲课:问题为什么在那个时代出现、提出者当时知道什么、走过哪些弯路。
这种教育制造出一种"有用的幻觉":学生会相信自己也能找到前人没想过的证明方法。虽然多数人达不到那个高度,但那份幻觉让人把疑问当成自己的事。
十岁那年的一件事他记了一辈子:老师问一平方公里等于多少德南,全班包括老师都答错了,只有他坚持一千德南。当天的嘲笑没让他改口,第二天老师公开认错。他由此确立了一条准则:结论如果是自己推导的,就要继续核查;人数多少和权威大小,永远不能替代证明本身。
从贝叶斯网络(把概率依赖画成图)到因果模型(给箭头加干预含义),他一生都在做同一件事:为人类习以为常的直觉,寻找一种能被计算、被检查、被证明的新语言。
二、因果阶梯:看见、行动、未发生的路
珀尔最著名的贡献是因果阶梯——推理的三个层级,存在严格的递进方向:
| 层级 | 问题 | 需要什么 |
|---|---|---|
| 第一层:关联 | 看到 X 后,Y 更可能是什么? | 观察数据、统计规律 |
| 第二层:干预 | 主动把 X 设成某值,Y 会怎样? | 实验数据或因果结构假设 |
| 第三层:反事实 | 已知结果,如果当初换条路会怎样? | 个体结果+完整因果模型 |
第一层处理"看见",第二层处理"行动",第三层处理"那条没有发生的路"。关键结论:数据再多,也不会自行生成干预语义——低层信息无法保证回答高层问题。实验能回答行动后果,却不能把同一个人送回过去。
珀尔特别强调:因果演算不只是给出答案,还要能识别问题属于哪一层、指出需要什么知识、判断数据是否足够——不足就老实承认,说明还缺哪类信息。
三、大模型为什么看起来"跨过了"因果阶梯?
这里有个表面矛盾:大模型主要从文本学习,却能解释疾病原因、讨论政策影响、回答反事实问题——看上去直接从关联层跳到了干预层甚至反事实层。
珀尔的解释非常直接:大模型接触的是一个已经被人类解释过的世界。论文数据被研究者筛选解释过,病例被医生诊断过,教材写满实验结论,新闻报道和个人叙述里包含大量因果判断。拿吸烟和癌症举例:模型通常不会直接面对原始患者表格独立判断因果,它读到的是医生、流行病学家对数据的解释、实验设计、机制推断和政策争论。
因果阶梯没有被绕开,只是输入里已经混入了大量高层人类知识。这划定了大模型的能力边界:它擅长把人类完成过的解释压缩进参数,再按问题组合输出——这项能力既神秘又有用,但珀尔质疑的是知识从哪里来、流畅的回答能证明什么。
四、它可以从互联网上"偷来"答案
珀尔提出的严格测试接近"自动化科学家":让机器直接观察原始数据,自己提出假设、设计实验、选择干预,再根据反馈更新模型——而不是从互联网文章里找现成结论。
按这个标准,当前大模型还没有证明自己具备独立的因果发现能力:它能复述和组合人类已有的解释,但还没显示出能在新环境里稳定完成观察、干预、反事实推演、模型修正的完整闭环。
面对"伪装出智能就是拥有智能"这句话,珀尔补上了更严格的条件:如果测试要求机器持续回答大量全新的因果问题,靠预存答案伪装就需要超指数级的存储,物理上几乎不可能——稳定通过本身就说明掌握了某种通用结构。但互联网大大降低了伪装成本:大量答案早就被人类写好,系统直接调用,不需要重走发现过程。他用了一个挑衅的说法——"它可以从互联网上偷来答案"。
他也不接受"大模型已经能编程实现意识"这类宣称,要求先给出可检验的定义:意识指什么、判据是什么、过去的原理性限制有哪些、新系统究竟克服了哪一项。
五、AGI 缺的三块拼图:干预、反事实、世界模型
珀尔绝不是全盘否定大模型:他充分肯定大模型在因果阶梯第一层的关键位置——从有限样本估计总体分布从来是困难问题,现代机器学习显著增强了模式识别、函数逼近和预测能力,这是实打实的进步。
在他看来,LLM 是构建更一般智能的重要工具,只是工具箱里还缺少:干预演算、反事实演算、可操作的世界模型。这里的"世界模型"指环境结构与运行机制的精炼表示——系统不需要保存每个问题的答案,而是根据底层机制在需要时自行推导。他把统计学习与因果演算的结合称为因果AI:真正的 AGI 要同时拥有从样本学习分布的能力,以及更高层级的推理行动后果、给出解释的能力。
珀尔用婴儿举例:婴儿反复敲打玩具,发现绿色的会响、黄色的不会——这个过程既包含观察,也包含主动改变环境的行动。通过行动获得可控感,婴儿才会安静下来。因果学习从一开始就和自主性纠缠在一起,无法分开。
六、好奇心与风险:控制欲的双刃剑
当主持人问"能否制造机器人婴儿让它们随机操作物体、共享实验数据",珀尔认可这条思路能补充文本学习的不足,但马上把问题推向更深处:系统为什么要持续探索?
他的假设是:人类身上有一种先天不安感,只有形成"我理解并且能控制环境"的感觉才会缓解。外部奖励能驱动行动,但未必足以解释开放式好奇心——猴子拿到香蕉会有反应,但撤掉奖励后不会追问香蕉怎样生长,更不会建立麦克斯韦方程。
但如果真把这种控制欲写进机器,马上会引出风险:持续追求环境控制的系统不会只满足于研究玩具——人类也是环境的一部分。珀尔构造了一个极端情境:机器人知道某人不愿让配偶知道的秘密,于是用秘密要挟对方。他特别说明这不是描述当前大模型的能力,而是推演自主探索目标的长远后果。拿掉好奇心,机器失去持续学习动力;保留控制冲动,人类必须处理目标边界问题。
有趣的是,讨论没有停在灾难想象上:他现场突然想到,足够公正仁慈又强大的机器人,或许反而会成为真实存在的"仁慈上帝"——至少人类清楚知道该付出什么代价换取一个请求。这段摇摆说明他的分析重点从来不是耸人听闻,而是认真拆解自主性需要的必要部件:因果模型、行动能力、好奇心、控制感。
七、为什么执着于模拟人类?"我想理解自己"
面对"为什么一定要模拟人类认知、机器的价值也许恰恰来自不同的思考方式",珀尔只给了六个字:我想理解自己。硅基可能突破生物限制,但材料不同不妨碍判断哪些认知功能可以形式化。只要还没发现某种能力原理上无法由硅系统模拟,机器就是检验思维理论的绝佳实验场——构建智能和理解人类智能,从来是同一个谜题的两面。
访谈尾声他对学术共同体给出了严厉评价:"为人类建立的最教条、最保守、最阻碍进步的组织之一"——源于因果科学进入统计学、经济学时遭遇的几十年阻力。他给学生的建议毫不绕弯:不要把教授的话当作权威,要保留反对老师的能力,甚至希望学生反驳他。曾经有人当面说"你根本不懂AI",他一开始未必接受,后来发现质疑迫使自己补上新知识,于是坦然承认对方说得有道理。
他把晚年的幸福概括为"幸福是感觉自己有用",也坦诚这种有用感可能本身就是一种幻觉——少年时代的"有用幻觉"让他相信自己能参与科学,几十年后仍然在驱动他处理未完成的谜题。
总结:珀尔在肯定语言模型能力的同时,看到了一条尚未闭合的链路:文本让机器继承了人类写下的知识,统计学习从样本中提取规律,因果模型让机器表达行动和未发生的可能性,世界模型让知识在环境变化后仍能被推导修正。等这些部件真正连接起来,机器才更接近他所说的"自动化科学家"。流畅回答,最多说明模型善于使用人类留下的解释;它是不是真的能独立解释这个世界,还要看它离开现成答案之后——怎样观察、怎样行动、怎样犯错,又怎样在犯错之后重建自己的模型。这个问题,可能才是我们真正需要思考的。